language dataset
stock dataset with a very limited number of languages installed:
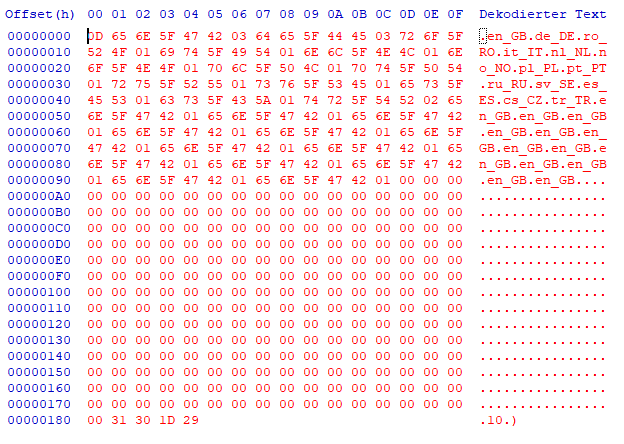
Dataset structure
- Byte 1 in dataset is the number of languages: 0D = 13
- However, the FW itself supports much more:
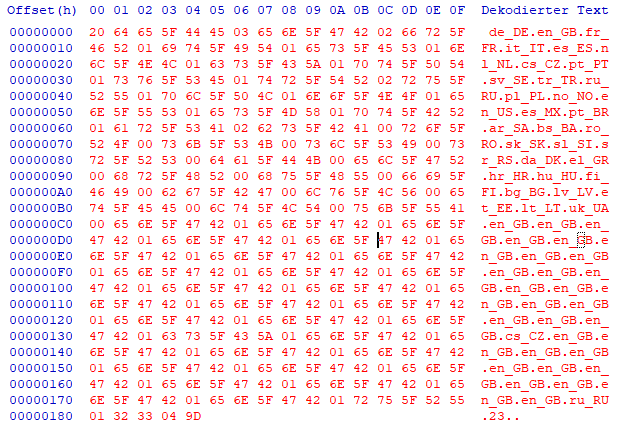
"de_DE,en_GB,fr_FR,it_IT,es_ES,nl_NL,cs_CZ,pt_PT,sv_SE,tr_TR,ru_RU,pl_PL,no_NO,en_US,es_MX,pt_BR,ar_SA,bs_BA,ro_RO,sk_SK,sl_SI,sr_RS,da_DK,el_GR,hr_HR,hu_HU,fi_FI,bg_BG,lv_LV,et_EE,lt_LT,uk_UA"
- Offset 181 next two bytes are the dataset version number
- Last two bytes are the checksum of the overall dataset: CRC-16/CCITT-False
GUI & Navigation language
For each language available in dataset, there is another language entry
13 languages + 13 en_GB (in the example above)
The 2nd language is the navigation voice output language.
Spacer byte
Each language in format xy_XY is 5 bytes long and after each of them there is one byte spacing to the next language.
This spacer byte can have different values: 00, 01, 02, 03
Table
| 1st language | bytes equivalent | 1st spacer byte | 2nd language | 2nd spacer byte |
|---|---|---|---|---|
| en_GB | 65 6E 5F 47 42 | 03 | ||
| de_DE | 64 65 5F 44 45 | 03 | ||
| fr_FR | 66 72 5F 46 52 | 01 | ||
| it_IT | 69 74 5F 49 54 | 01 | ||
| nl_NL | 6E 6C 5F 4E 4C | 01 | ||
| no_NO | 6E 6F 5F 4E 4F | 01 | ||
| pl_PL | 70 6C 5F 50 4C | 01 | ||
| pt_PT | 70 74 5F 50 54 | 01 | ||
| ru_RU | 72 75 5F 52 55 | 01 | ||
| sv_SE | 73 76 5F 53 45 | 01 | ||
| es_ES | 65 73 5F 45 53 | 01 | ||
| cs_CZ | 63 73 5F 43 5A | 01 | en_GB | 01 |
| tr_TR | 74 72 5F 54 52 | 02 | ||
| uk_UA | 75 6B 5F 55 41 | 00 | ||
| bg_BG | 62 67 5F 42 47 | 00 | en_GB | 01 |
| da_DK | 64 61 5F 44 4B | 00 | ||
| el_GR | 65 6C 5F 47 52 | 00 | ||
| et_EE | 65 74 5F 45 45 | 00 | ||
| fi_FI | 66 69 5F 46 49 | 00 | ||
| hr_HR | 68 72 5F 48 52 | 00 | ||
| hu_HU | 68 75 5F 48 55 | 00 | ||
| lt_LT | 6C 74 5F 4C 54 | 00 | ||
| lv_LV | 6C 76 5F 4C 56 | 00 | ||
| ro_RO | 72 6F 5F 52 4F | 01 or 00 ??? | ||
| sk_SK | 73 6B 5F 53 4B | 00 | ||
| sl_SI | 73 6C 5F 53 49 | 00 | ||
| sr_RS | 73 72 5F 52 53 | 00 | ||
| es_MX | 65 73 5F 4D 58 | 01 | ||
| en_US | 65 6E 5F 55 53 | 01 | ||
| pt_BR | 70 74 5F 42 52 | 01 | ||
| ar_SA | 61 72 5F 53 41 | 02 | ||
| fr_CA | 01 | |||
| bs_BA | 62 73 5F 42 41 | 00 | en_GB | 01 |
Assumption: Spacer byte has something todo with level of translation available for this language.
-
GUI language
-
SDS?
-
Navigation TTS?
-
Navigation Map language??
\
in the 2nd language dataset part, which in mostly en_GB this spacier byte is always 01
However, also ru_RU and cs_CZ are used.
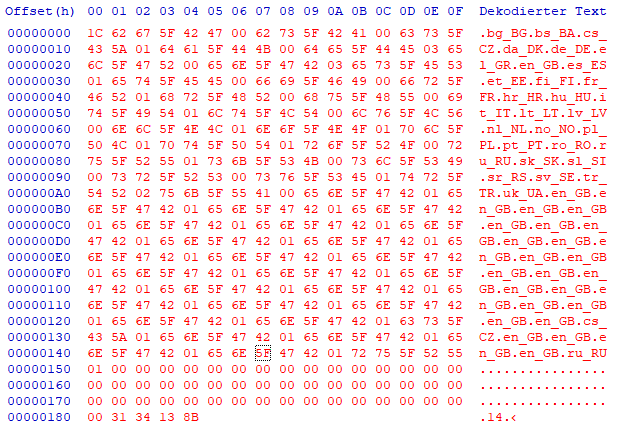
1c62675f42470062735f42410063735f435a0164615f444b0064655f444503656c5f475200656e5f47420365735f45530165745f45450066695f46490066725f46520168725f48520068755f48550069745f4954016c745f4c54006c765f4c56006e6c5f4e4c016e6f5f4e4f01706c5f504c0170745f505401726f5f524f0072755f525501736b5f534b00736c5f53490073725f52530073765f53450174725f545202756b5f554100656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f474201656e5f47420163735f435a01656e5f474201656e5f474201656e5f474201656e5f47420172755f5255010000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000003134138b
Counting positions in 1st and 2nd block languages:
- uk_UA --> ru_RU
- sk_SK -> cs_CZ
do match, also in other datasets.
Test dataset MAX LANG:
2064655F444503656E5F47420266725F46520169745F49540165735F4553016E6C5F4E4C0163735F435A0170745F50540173765F53450174725F54520272755F525501706C5F504C016E6F5F4E4F01656E5F55530165735F4D580170745F42520161725F53410262735F424100726F5F524F00736B5F534B00736C5F53490073725F52530064615F444B00656C5F47520068725F48520068755F48550066695F46490062675F4247006C765F4C560065745F4545006C745F4C5400756B5F554100656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F47420163735F435A01656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F474201656E5F47420172755F5255013233049D